AI 识别三页单据总失败,我学到:空结果也是失败
这周我在一个 bug 上花了不少时间。修完之后,我觉得最值得记下来的不是代码本身,而是一条和 AI 协作的心法:AI 安静地返回一个空结果,比直接报错更危险。
事情是这样的
我在做一个「单据对比器」,用来帮餐饮门店核对供应商的单据:月结单、invoice、送货单(DO),还有供应商价格总单,这几份上的信息要一致。这周刚给它加了 DO 核对,所有单据都能传 PDF 或照片。
上线测试时,一张 3 页、111 行的月结单怎么都识别不出来。
我让 Claude 先 /plan,把原因查清楚再动手。查出来是这样:
- 3 页一起交给 Qwen3.8 Flash,推理过程把 max_tokens 占满了,跑了 100 秒,最后只回了一个
[]; - 换成 Gemini,正文被截断;
- 每次都要 100–200 秒,超过系统设的 120 秒超时,也超过 Cloudflare 的 100 秒限制。
最要命的是,系统把这个 [] 当成「识别成功」,存成了一份空单据。表面上一切正常,谁也不会发现。
第一条:空结果按失败处理
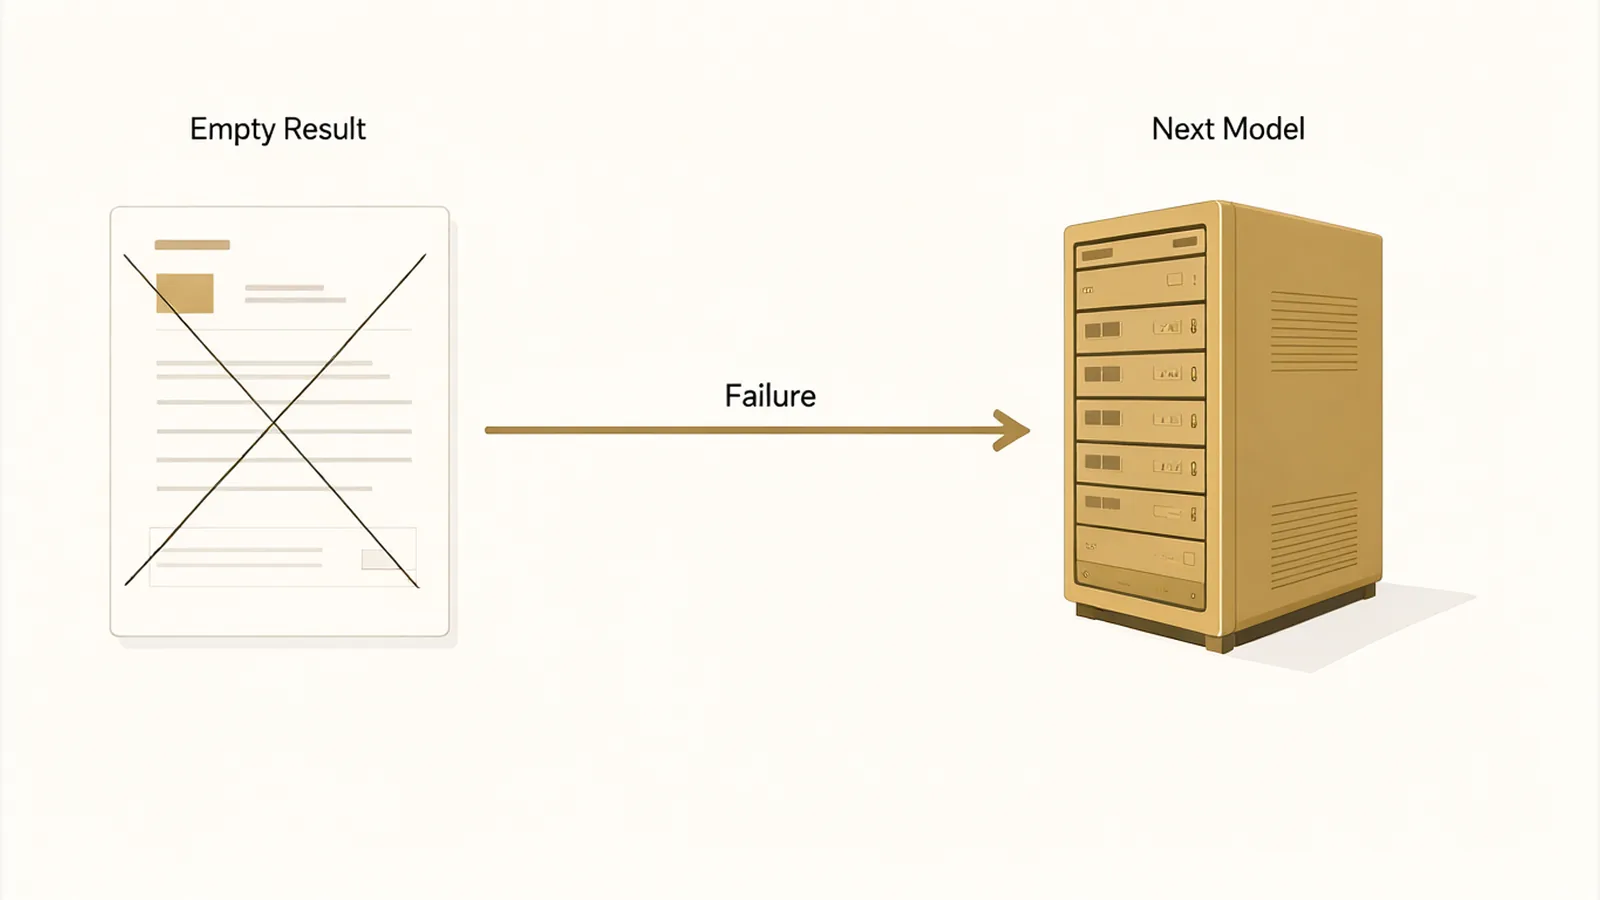
以前的降级链只在模型报错时才换下一档。但大模型很多时候不会报错,它会给你一个看起来合法、其实什么都没有的答案。
现在的规则是:
- 模型只回
[]或null,算识别失败; finish_reason=length(输出被截断),算失败;- 某一页读出 0 行,先换下一档模型再说。
命中任何一条,降级链就自动换下一个模型,不会再存一份空单据。
第二条:大任务拆小,再并发
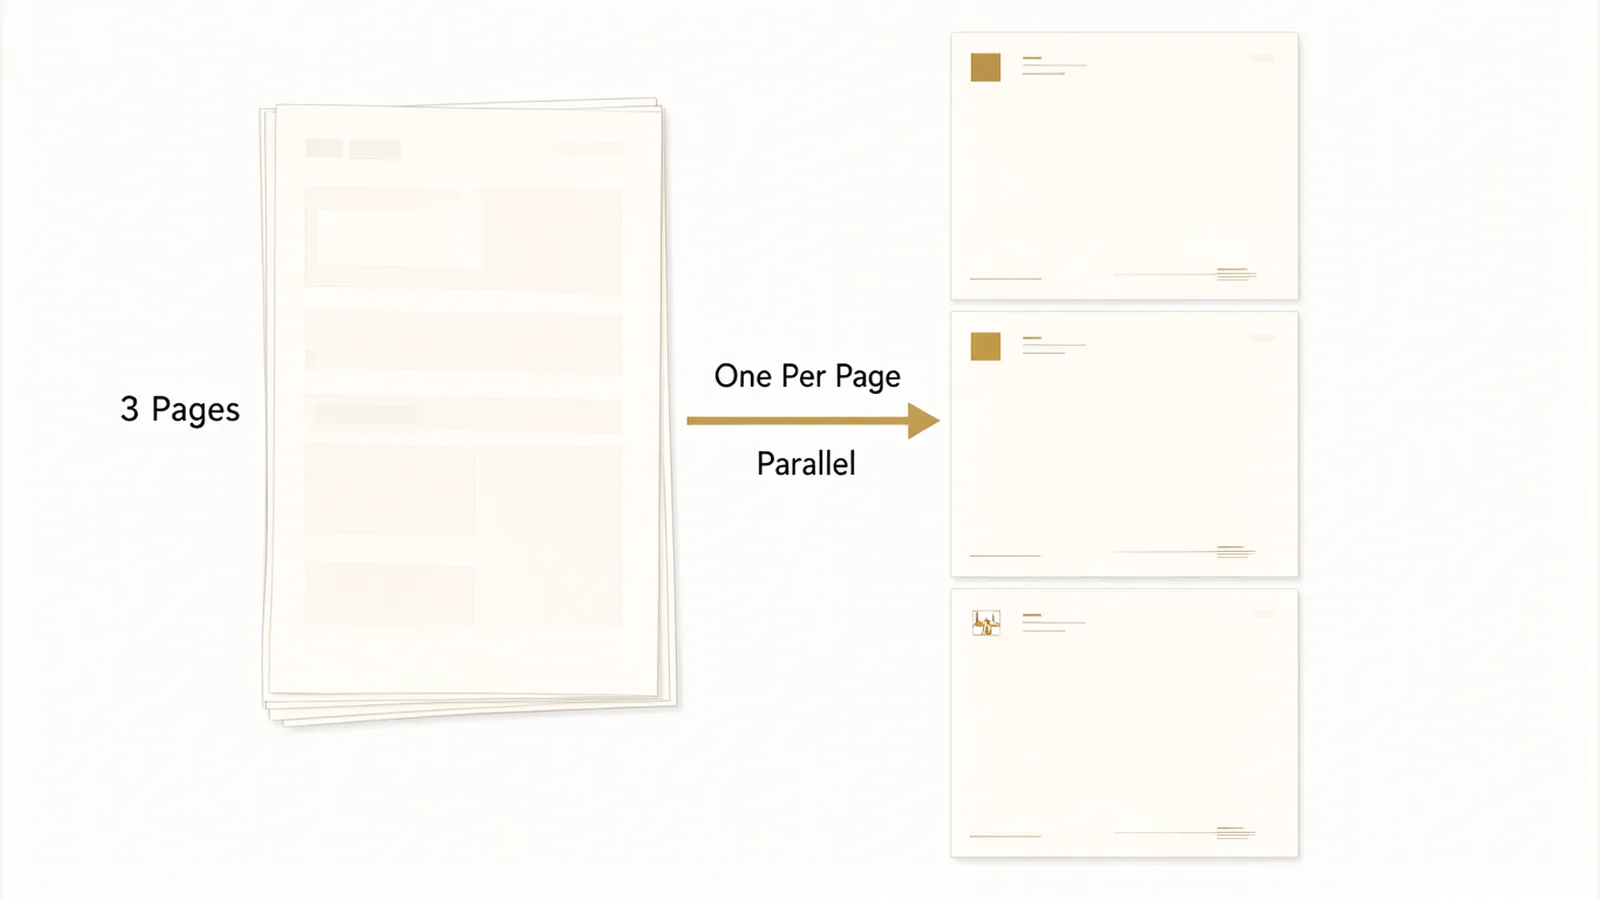
一次塞 3 页,模型既要看又要推理又要输出 110 多行,token 和时间都不够用。拆开反而简单了:
- 每页单独识别,最多 6 页并发;
- 每页各走自己的降级链,一页失败不拖累其他页;
- 识别月结单这种「照着抄」的任务,把 Qwen 的推理关掉、Gemini 调成低推理,省下的 token 都用来输出;
- max_tokens 从 16000 提到 32000。
改完再测同一张月结单:27–50 秒识别完,110 行,余额链和期末余额都对得上。
中间也不是一次就好,有一版上线后点「识别」立刻就失败,又回头查了一轮。这就是真实的开发节奏。
我带走的工作流
- 先让 AI 查原因再改,别一上来就让它「修好」;
- 定义清楚什么算失败,空的、截断的、0 行的都算;
- 任务太大就拆小,每个小块各自兜底;
- 不需要推理的任务就别让模型推理。
这几条不只适用于单据识别,任何把大模型接进生产流程的场景都用得上。
你在用 AI 的时候,有没有遇到过这种「看起来成功、其实是空的」情况?欢迎留言聊聊。如果你的门店或公司也有类似的对账、单据核对需求,也可以私信我。